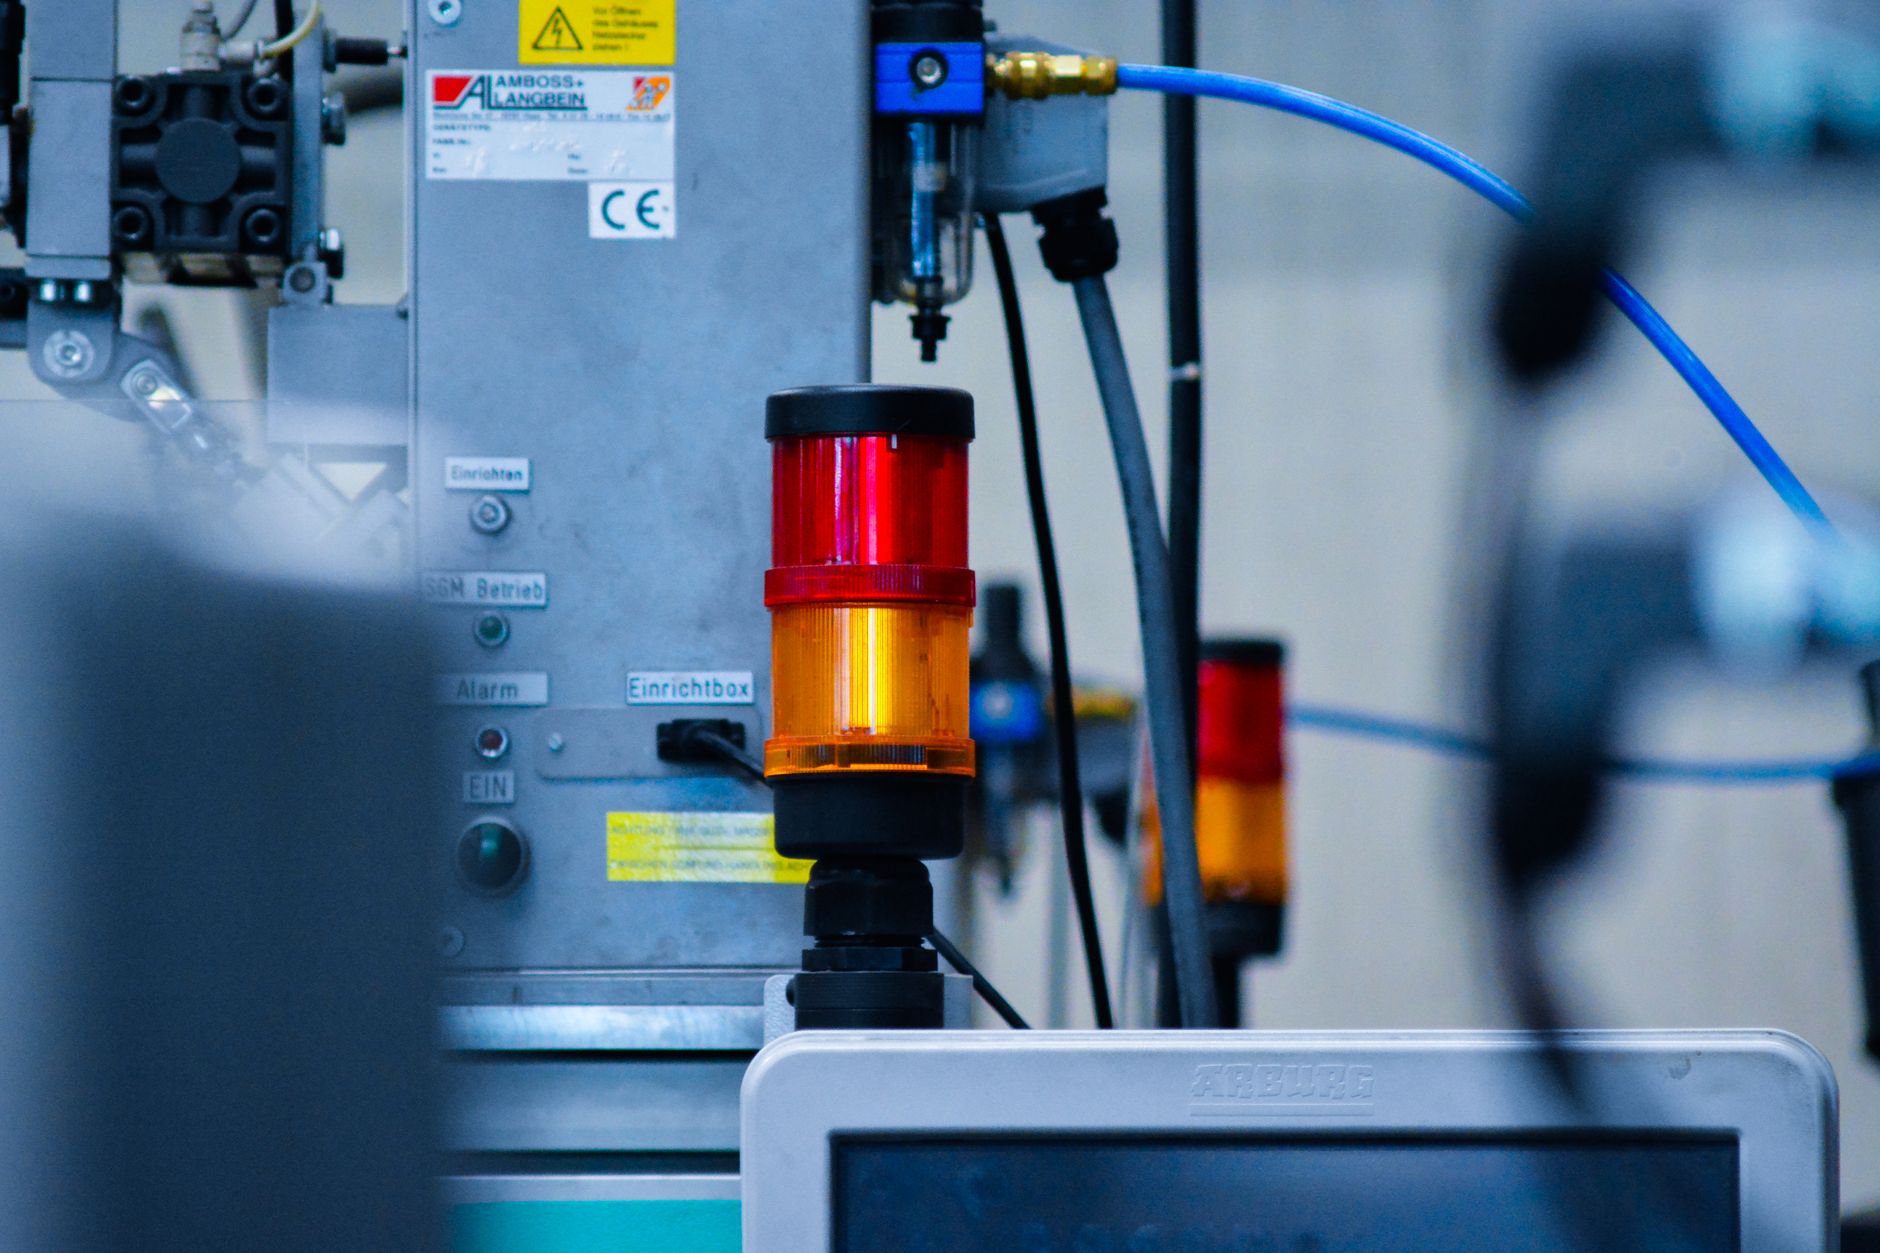
W zakładzie produkcyjnym każda minuta przestoju ma wymierną cenę. Zatrzymana linia oznacza nie tylko niewykonany plan, lecz także opóźnienia w dostawach, dodatkową pracę zespołu utrzymania ruchu i napięcie w relacjach z klientami. Dlatego firmowe IT coraz częściej przestaje być zapleczem odpowiedzialnym wyłącznie za komputery, sieć i pocztę. Staje się jednym z elementów systemu, który wspiera dostępność maszyn, przepływ informacji oraz sprawne reagowanie na zakłócenia.
IT i produkcja muszą korzystać z tych samych danych
W wielu firmach środowisko biurowe i produkcyjne nadal funkcjonują osobno. Dział IT monitoruje serwery, urządzenia sieciowe, konta użytkowników i kopie zapasowe, a utrzymanie ruchu skupia się na stanie mechanicznym oraz elektrycznym maszyn. Tymczasem granica między tymi obszarami jest coraz mniej wyraźna. Sterowniki PLC, panele operatorskie, systemy SCADA, czujniki IoT, terminale magazynowe i oprogramowanie MES są zależne od stabilnej infrastruktury cyfrowej.
Awaria przełącznika sieciowego, źle działający punkt dostępowy Wi-Fi czy przepełniona przestrzeń dyskowa serwera mogą zatrzymać proces równie skutecznie jak uszkodzony napęd. Jeżeli zespoły działają niezależnie, diagnoza trwa dłużej: produkcja zgłasza problem z maszyną, utrzymanie ruchu sprawdza podzespoły, a dopiero później ktoś weryfikuje komunikację lub działanie aplikacji. W dobrze zorganizowanym środowisku informacja od początku trafia do właściwych osób, a dane pozwalają szybko zawęzić źródło problemu.
Monitoring powinien pokazywać zależności, nie tylko alarmy
Skuteczny monitoring nie polega na ustawieniu jak największej liczby powiadomień. Nadmiar alertów prowadzi do sytuacji, w której pracownicy przestają traktować je poważnie. Znacznie ważniejsze jest wskazanie parametrów faktycznie wpływających na ciągłość pracy: dostępności kluczowych serwerów, opóźnień w sieci przemysłowej, stanu zasilania awaryjnego, temperatury w szafach sterowniczych, wykorzystania zasobów oraz poprawności komunikacji między systemami.
Warto monitorować także procesy, a nie tylko urządzenia. Jeżeli system MES nie odbiera danych z linii, alarm powinien informować nie wyłącznie o błędzie usługi, ale również o potencjalnym wpływie na raportowanie produkcji lub identyfikowalność partii. Podobnie brak danych z czujnika może oznaczać awarię samego czujnika, problem z siecią albo błąd integracji. Dobre narzędzia pozwalają zestawić te sygnały w jednym widoku i ocenić, który incydent wymaga natychmiastowej interwencji.
Istotne są również trendy. Jednorazowy wzrost temperatury czy chwilowe spowolnienie bazy danych nie zawsze oznaczają krytyczny problem. Jeśli jednak takie zdarzenia powtarzają się regularnie, mogą zapowiadać przeciążenie infrastruktury, pogarszający się stan urządzenia lub niewłaściwie zaprojektowaną konfigurację. Monitoring ma największą wartość wtedy, gdy pomaga zapobiegać przestojom, a nie tylko je rejestrować.
Szybka reakcja wymaga jasno podzielonej odpowiedzialności
Nawet najlepszy system alarmowy nie poprawi dostępności produkcji, jeśli po otrzymaniu zgłoszenia nikt nie wie, co robić. Warto przygotować proste procedury dla najczęstszych scenariuszy: utraty połączenia z linią, niedostępności serwera aplikacyjnego, awarii zasilania, problemów z dostępem do danych czy podejrzenia incydentu cyberbezpieczeństwa. Powinny one określać, kto przyjmuje zgłoszenie, kto prowadzi diagnostykę, w jakim czasie należy podjąć działanie i kiedy eskalować sprawę.
Praktyczne są krótkie instrukcje operacyjne, często nazywane runbookami. Mogą zawierać kolejność sprawdzeń, dane kontaktowe, lokalizację urządzeń, sposób przełączenia na rozwiązanie zapasowe oraz zasady dokumentowania incydentu. Dzięki temu pierwsza reakcja nie zależy wyłącznie od doświadczenia konkretnej osoby. To szczególnie ważne podczas pracy zmianowej, urlopów czy nagłych awarii poza standardowymi godzinami pracy.
Warto też ustalić wspólny język pomiędzy IT a działem produkcji. Zamiast ogólnego komunikatu „system nie działa”, lepiej zgłosić, od kiedy występuje problem, jakiej linii dotyczy, jakie komunikaty widzi operator i czy produkcja została całkowicie zatrzymana. Z kolei zespół techniczny powinien przekazać jasną informację o przewidywanym wpływie awarii oraz kolejnym kroku, a nie ograniczać się do stwierdzenia, że „trwa analiza”.
Odporność techniczna trzeba budować warstwowo
Ciągłość działania nie opiera się na jednym zabezpieczeniu. Potrzebne są rozwiązania zapasowe tam, gdzie ich brak powoduje zatrzymanie krytycznego procesu: redundantne łącza, zasilanie UPS, kopie konfiguracji urządzeń, regularnie testowane backupy oraz możliwość odtworzenia najważniejszych serwerów. Nie każda maszyna i aplikacja wymaga takiego samego poziomu ochrony, dlatego warto wcześniej określić priorytety biznesowe.
Równie istotne jest bezpieczeństwo. Nieaktualne oprogramowanie, wspólne konta użytkowników czy zdalny dostęp bez odpowiednich zabezpieczeń zwiększają ryzyko zdarzeń, które mogą unieruchomić produkcję na wiele godzin lub dni. Segmentacja sieci, kontrola dostępu i aktualizacje powinny być wdrażane ostrożnie, z uwzględnieniem specyfiki środowiska przemysłowego oraz okien serwisowych.
Monitoring, procedury i odporna infrastruktura nie zastąpią działań związanych z samymi urządzeniami produkcyjnymi, ale skutecznie je uzupełniają. W planowaniu warto korzystać również z wiedzy o sposobach ograniczania awarii maszyn, ponieważ dopiero połączenie danych technicznych, organizacji pracy i sprawnej komunikacji pozwala ograniczać ryzyko kosztownych przestojów.